Как использовать AdsCrawl с Cloudflare Developer Docs
Быстрый обзор
Узнайте, как объединить API автоматизации браузера AdsCrawl с Cloudflare Developer Docs для сбора отрендеренной документации и создания надежных контекстных конвейеров для ИИ.
Как использовать AdsCrawl с Cloudflare Developer Docs
Документация для разработчиков — один из самых ценных источников контекста для ИИ-агентов, помощников по коду и внутренних баз знаний. Ее также сложнее всего собирать надежно: сайты документации насыщены JavaScript, разбиты на страницы, версионированы и все чаще защищены от ботов. Cloudflare Developer Docs публикует справочные материалы для платформы разработчика и периферийной инфраструктуры Cloudflare, а AdsCrawl предоставляет уровень автоматизации браузера, который превращает эти страницы в чистый структурированный вывод.
В этом руководстве объясняется, как они сочетаются, описываются рабочий процесс и шаги настройки, практические примеры и проблемы, которые решает комбинация. Оно написано для разработчиков, создающих контекстные конвейеры для ИИ, зеркала документации или автоматическое отслеживание изменений.
Зачем объединять AdsCrawl с Cloudflare Developer Docs
Скриншот первого экрана сайта developers.cloudflare.com.
Cloudflare Developer Docs — канонический источник информации о работе платформы разработчика Cloudflare: Workers, Pages, R2, D1, KV, Durable Objects и более широкого стека периферийной инфраструктуры. Если вы создаете что-то на этой платформе или ИИ-агента, отвечающего на вопросы о ней, вам нужна документация в машиночитаемой форме.
Сложность в том, что сайты документации — не статические HTML-файлы. Многие отрисовывают навигацию, примеры кода и переключатели версий на стороне клиента. Некоторые применяют ограничения скорости или проверки на ботов. Простой HTTP-запрос часто возвращает оболочку страницы, а не нужный контент.
AdsCrawl решает это с помощью реального браузерного окружения. Он предлагает синхронные эндпоинты для скриншотов, отрендеренного HTML, Markdown и извлечения SPA, а также сессионные удаленные Chromium-сессии, подключаемые к Playwright, Puppeteer или клиентам CDP. Для работы с документацией эндпоинт Markdown обычно наиболее полезен: он возвращает читаемое содержимое отрендеренной страницы без навигационной обвязки.
Разделение обязанностей простое:
- Cloudflare Developer Docs — источник истины о поведении платформы, справочниках API и примерах конфигурации.
- AdsCrawl — уровень извлечения и рендеринга, который выдает этот контент в пригодном формате, масштабируемо и без блокировок.
Что дает каждый продукт
Скриншот первого экрана сайта developers.cloudflare.com.
Cloudflare Developer Docs: справочный уровень
Cloudflare Developer Docs организует документацию по продуктам и задачам. Она охватывает конфигурацию, лимиты, цены и примеры кода для платформы разработчика. Для контекстных конвейеров ИИ документация ценна тем, что она авторитетна и часто обновляется. Она также включает индекс llms.txt, предназначенный для того, чтобы помочь ИИ-системам обнаруживать и навигировать по структуре документации.
AdsCrawl: уровень рендеринга и извлечения
AdsCrawl — это API автоматизации браузера и облачная браузерная платформа. Его возможности, важные для работы с документацией, включают:
- Синхронные эндпоинты для отрендеренного HTML, Markdown, JSON и скриншотов.
- Сессионные удаленные Chromium-сессии для многошаговых рабочих процессов.
- Управляемую идентичность браузера, случайные User-Agent, доверенные прокси и маршрутизацию через резидентные прокси.
- Динамическую маршрутизацию по регионам для геозависимого контента.
- Сохраненные облачные профили браузера с управлением жизненным циклом и доступом через интерактивный просмотрщик.
- Спецификацию OpenAPI и удобный для ИИ индекс
llms.txtдля собственной документации.
Для сбора документации комбинация вывода Markdown и маршрутизации через прокси делает рабочий процесс практичным в масштабе.
Рабочий процесс: от URL документации к структурированному контексту
Скриншот первого экрана сайта developers.cloudflare.com.
Надежный конвейер документации состоит из пяти этапов. Каждый этап соответствует определенной возможности AdsCrawl.
Этап 1: Обнаружение структуры документации
Начните с индекса llms.txt, который публикует Cloudflare Developer Docs. Он перечисляет основные разделы документации и дает карту сайта. Используйте его для составления начального списка URL, а не для слепого обхода.
Если нужно пройти по навигационным ссылкам, отрисовываемым на стороне клиента, используйте эндпоинт отрендеренного HTML AdsCrawl, чтобы захватить страницу после выполнения JavaScript, а затем извлеките ссылки из этого вывода.
Этап 2: Рендеринг каждой страницы в реальном браузере
Для каждого URL из начального списка запросите вывод Markdown из AdsCrawl. Это вернет читаемое содержимое страницы после того, как браузер выполнит JavaScript. Вы избегаете типичного сбоя, когда статический запрос возвращает загрузочную оболочку или частичную страницу.
Этап 3: Нормализация и разбиение контента
Вывод Markdown легче разбивать на части, чем сырой HTML. Разделите контент по структуре заголовков так, чтобы каждый фрагмент соответствовал разделу документации. Сохраняйте исходный URL и заголовок страницы как метаданные, чтобы последующее извлечение могло ссылаться на оригинальную страницу.
Этап 4: Хранение и индексация
Сохраните нормализованные фрагменты в вашем векторном хранилище, поисковом индексе или базе знаний. Если вы строите на самом Cloudflare, Workers KV, R2 или D1 — естественные цели для хранения. Та же платформа, что размещает документацию, может разместить и ваш контекстный конвейер.
Этап 5: Обновление по расписанию
Документация меняется. Запланируйте периодические повторные обходы и сравнивайте хеши вывода Markdown для обнаружения изменений. Переиндексируйте только те страницы, которые действительно изменились. Это поддерживает актуальность контекста без повторной обработки всего сайта.
Шаги настройки
Шаг 1: Получите ключ API AdsCrawl
Зарегистрируйте учетную запись AdsCrawl. Новые аккаунты получают 500 бесплатных кредитов, чего достаточно для тестирования обхода документации перед переходом на платный план. Планы Free, Hobby, Starter и Pro основаны на кредитах, поэтому вы можете масштабироваться по мере роста объема обхода.
Шаг 2: Выберите эндпоинт
Для большинства задач с документацией правильным выбором будет эндпоинт Markdown. Используйте эндпоинт отрендеренного HTML, когда нужно исследовать DOM или извлечь структурированные данные, например деревья навигации. Используйте скриншоты, когда нужна визуальная проверка макета страницы.
Шаг 3: Настройте прокси и регион
Если сайт документации применяет геозависимое поведение или защиту от ботов, настройте маршрутизацию через резидентные прокси и динамическую маршрутизацию по регионам в вашем запросе. Управляемая идентичность браузера и случайные User-Agent в AdsCrawl помогают запросам выглядеть как обычный браузерный трафик.
Шаг 4: Постройте цикл обхода
Переберите начальные URL, вызовите эндпоинт AdsCrawl для каждого и запишите вывод в слой хранения. Добавьте повторные попытки и ограничение скорости, чтобы уложиться в бюджет кредитов и не перегружать целевой сайт.
Шаг 5: Проверьте вывод
Выборочно проверьте несколько страниц. Убедитесь, что блоки кода, таблицы и заголовки сохранились при преобразовании. Преобразование в Markdown иногда может упрощать сложные таблицы, поэтому проверяйте такие страницы особенно тщательно.
Практические примеры
Пример 1: Создание ИИ-помощника для Cloudflare Workers
Предположим, вы создаете внутреннего помощника, который отвечает на вопросы о развертывании Workers. Вам нужна документация Workers, справочник по API среды выполнения и соответствующие страницы конфигурации.
- Загрузите индекс
llms.txt, чтобы определить раздел Workers. - Обойдите каждую страницу с помощью эндпоинта Markdown AdsCrawl.
- Разбейте по заголовкам и сохраните с исходными URL.
- Подключите индекс к вашему слою извлечения.
Когда разработчик спрашивает, как настроить привязку, помощник извлекает соответствующий фрагмент и ссылается на оригинальную страницу документации.
Пример 2: Отслеживание изменений документации
Платформы часто обновляют свою документацию. Если ваш продукт интегрируется с Cloudflare, вы хотите знать, когда меняется соответствующая страница.
- Обходите целевые страницы еженедельно с помощью AdsCrawl.
- Вычисляйте хеш вывода Markdown для каждой страницы.
- Сравнивайте хеши с предыдущим запуском.
- Отправляйте уведомление о различиях для измененных страниц.
Это легкая система обнаружения изменений, не требующая разбора полного HTML-диффа.
Пример 3: Проверка документации в нескольких регионах
Некоторые разделы документации содержат региональные ограничения или примечания о доступности. Используйте динамическую маршрутизацию по регионам AdsCrawl, чтобы получать одну и ту же страницу из разных регионов и сравнивать отрендеренный вывод. Это выявляет региональные различия, которые пропустил бы обход из одного региона.
Проблемы, которые решает комбинация
| Проблема | Как комбинация ее решает |
|---|---|
| Документация, отрисовываемая JavaScript, возвращает пустые оболочки | AdsCrawl рендерит страницы в реальном браузере перед извлечением |
| Защита от ботов блокирует автоматические запросы | Управляемая идентичность браузера, случайные User-Agent и резидентные прокси |
| Сырой HTML трудно разбивать на части | Вывод Markdown сохраняет структуру и легче разделяется |
| Контент меняется незаметно | Плановые повторные обходы со сравнением хешей обнаруживают обновления |
| Региональные различия не видны | Динамическая маршрутизация по регионам получает геозависимые варианты |
| Многошаговая документация с аутентификацией | Сессионные удаленные Chromium-сессии сохраняют состояние сессии |
Когда использовать AdsCrawl, а когда более простые подходы
Не каждому конвейеру документации нужен полноценный API автоматизации браузера. Используйте это руководство по выбору:
- Статическая HTML-документация без защиты от ботов: может быть достаточно простого HTTP-клиента и HTML-парсера.
- Документация, отрисовываемая JavaScript: используйте эндпоинт Markdown или отрендеренного HTML AdsCrawl.
- Документация за защитой от ботов или ограничениями скорости: используйте AdsCrawl с маршрутизацией через прокси.
- Документация с аутентификацией или многошаговыми сценариями: используйте сессионную удаленную Chromium-сессию с Playwright или Puppeteer.
- Высокообъемные повторяющиеся обходы: используйте платный план AdsCrawl и планируйте повторные обходы с обнаружением изменений.
Если вы сравниваете варианты автоматизации браузера в более широком смысле, см. сравнение AdsCrawl vs Steel vs Zyte для разбора рабочих процессов CDP против управляемой доставки данных. Для рабочих процессов с интенсивным использованием сессий руководство по сохранению сессий в автоматизации браузера объясняет, как сессионные сессии сохраняют файлы cookie и логины между шагами.
Связанное чтение
- AdsCrawl vs ScreenshotEngine vs Screenshotlayer: руководство 2026 — Сравните AdsCrawl, ScreenshotEngine и Screenshotlayer для скриншотов, управления браузером и извлечения данных. Найдите подходящий инструмент для вашего рабочего процесса.
- AdsCrawl vs Lexmount: облачный браузерный API для ИИ-агентов — Сравните AdsCrawl и Lexmount Cloud Browser API для ИИ-агентов. Узнайте, какой предлагает лучший контроль CDP, извлечение данных, цены и поддержку прокси.
- Обзор Steel: облачная браузерная инфраструктура для ИИ-агентов — Обзор Steel на основе фактов, охватывающий идеальных пользователей, варианты использования, сильные стороны, ограничения, цены, настройку и критерии выбора браузерной инфраструктуры для ИИ-агентов.
Источники и дополнительное чтение
- Remote MCP Servers — Официальный MCP-сервер Ahrefs, который позволяет ИИ-агентам безопасно получать доступ к SEO-данным Ahrefs, метрикам сайтов, исследованию ключевых слов и анализу конкурентов через API Ahrefs.
- Agentic Access Index - APIs.io — Просмотрите рекомендуемые контракты выполнения x-agentic-access для поставщиков API в сети APIs.io — класс действия, уровень последствий, область действия, краткосрочные токены и эскалация с участием человека для каждой операции, которую может вызвать ИИ-агент. Классифицировано из OpenAPI поставщика согласно Curity
- Как «клиентский мозг» дает ИИ контекст, необходимый для SEO-работы — Структурированная память клиента помогает работе, сгенерированной ИИ, оставаться основанной на рекомендациях бренда, истории кампаний и технических ограничениях.
Часто задаваемые вопросы
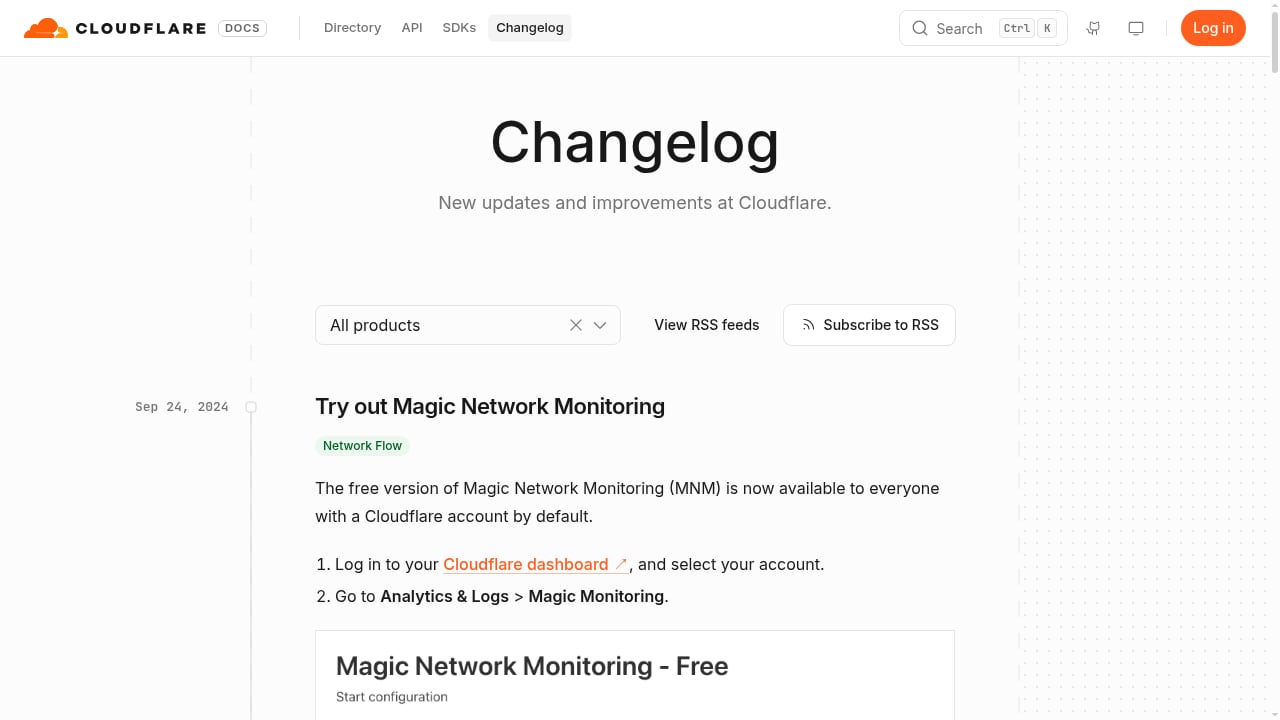
Скриншот первого экрана сайта developers.cloudflare.com.
Что такое Cloudflare Developer Docs?
Cloudflare Developer Docs — это сайт документации для платформы разработчика и периферийной инфраструктуры Cloudflare. Он охватывает такие продукты, как Workers, Pages, R2, D1, KV и Durable Objects, включая конфигурацию, лимиты и примеры кода.
Работает ли AdsCrawl с любым сайтом документации, а не только с Cloudflare?
Да. AdsCrawl — это универсальный API автоматизации браузера. Описанный здесь рабочий процесс применим к любому сайту документации, который отрисовывает контент с помощью JavaScript или применяет защиту от ботов. Cloudflare Developer Docs — просто хорошо структурированный пример.
Можно ли использовать AdsCrawl без написания кода автоматизации браузера?
Да. Синхронные эндпоинты для Markdown, HTML и скриншотов можно вызывать напрямую через HTTP-запросы. Сессионные удаленные Chromium-сессии доступны, когда вам нужен контроль через Playwright, Puppeteer или чистый CDP.
Как поддерживать актуальность контекста документации?
Планируйте повторяющиеся обходы и сравнивайте хеши контента между запусками. Переиндексируйте только изменившиеся страницы. Планы AdsCrawl на основе кредитов делают это предсказуемым по стоимости.
Есть ли удобный для ИИ индекс собственной документации AdsCrawl?
Да. AdsCrawl публикует спецификацию OpenAPI и индекс llms.txt, предназначенные для того, чтобы ИИ-системы могли обнаруживать и навигировать по его документации.
Что делать, если страница не рендерится?
Добавьте повторные попытки и логику отката в цикл обхода. Если страница стабильно не работает, исследуйте ее с помощью скриншота или запроса отрендеренного HTML, чтобы определить, является ли проблема защитой от ботов, ошибкой на стороне клиента или структурным изменением страницы.
Заключение
Объединение AdsCrawl с Cloudflare Developer Docs дает надежный способ превратить авторитетную документацию платформы в структурированный машиночитаемый контекст. AdsCrawl берет на себя сложные части извлечения: рендеринг JavaScript, защиту от ботов, маршрутизацию через прокси и структурированный вывод. Cloudflare Developer Docs предоставляет справочный материал, необходимый ИИ-агентам, помощникам по коду и внутренним инструментам для точных ответов на реальные вопросы.
Начните с индекса llms.txt, обойдите небольшой раздел с помощью эндпоинта Markdown и проверьте вывод перед масштабированием. Как только конвейер станет стабильным, добавьте обнаружение изменений и плановые обновления. В результате вы получите слой контекста документации, который остается точным по мере развития платформы.