2026年十大网页抓取浏览器扩展
2026年十大网页抓取浏览器扩展独立排名,包含定价、限制、分页证据,以及何时应转向抓取API。
2026年十大网页抓取浏览器扩展
网页抓取浏览器扩展是将你正在查看的页面快速转换为电子表格的最快方式。无需Python、无需终端、无需单独的桌面应用。但这一类别工具众多,且并非可互换:有些是一键表格抓取器,另一些则是可复用的多页抓取器,背后有云执行支持。
本2026年排名涵盖十款真正属于网页抓取浏览器扩展类别的扩展。每个条目均按相同标准评分,证据来自第一方文档、浏览器商店列表和公开定价。当任务超出浏览器能力时,我们会注明向基础设施工具(如AdsCrawl,一个用于动态页面和认证会话的浏览器自动化API)的交接,但不将其视为扩展。
我们如何评估这些扩展
dataminer.io首屏截图。
每个产品在排名前都必须满足基线要求:当前官方浏览器商店列表、结构化数据提取作为核心功能(而非通用自动化工具的附属功能),以及足够的第一方文档来验证工作流程。仅桌面端抓取器、代理插件以及没有扩展的纯API被排除在外。
然后,对排名产品按六项加权标准评分:
- 提取工作流(25%): 一键自动检测 vs 可视化选择器构建器 vs 保存的配方或站点地图。
- 多页能力(20%): 分页、无限滚动和列表到详情页的抓取。
- 可复用性(15%): 配置能否保存、共享并在网站变化时重新运行。
- 导出与集成(15%): CSV、Excel、Google Sheets、JSON、webhooks或API输出。
- 执行模型(15%): 仅本地 vs 可选云运行、调度和并发。
- 入门成本与限制(10%): 免费层页面上限和第一个付费层的价格。
排名反映工作流覆盖的广度,而非受控的速度基准。关于特定网站准确性的声明需要为每个扩展提供相同的测试页面。
2026年十大网页抓取浏览器扩展
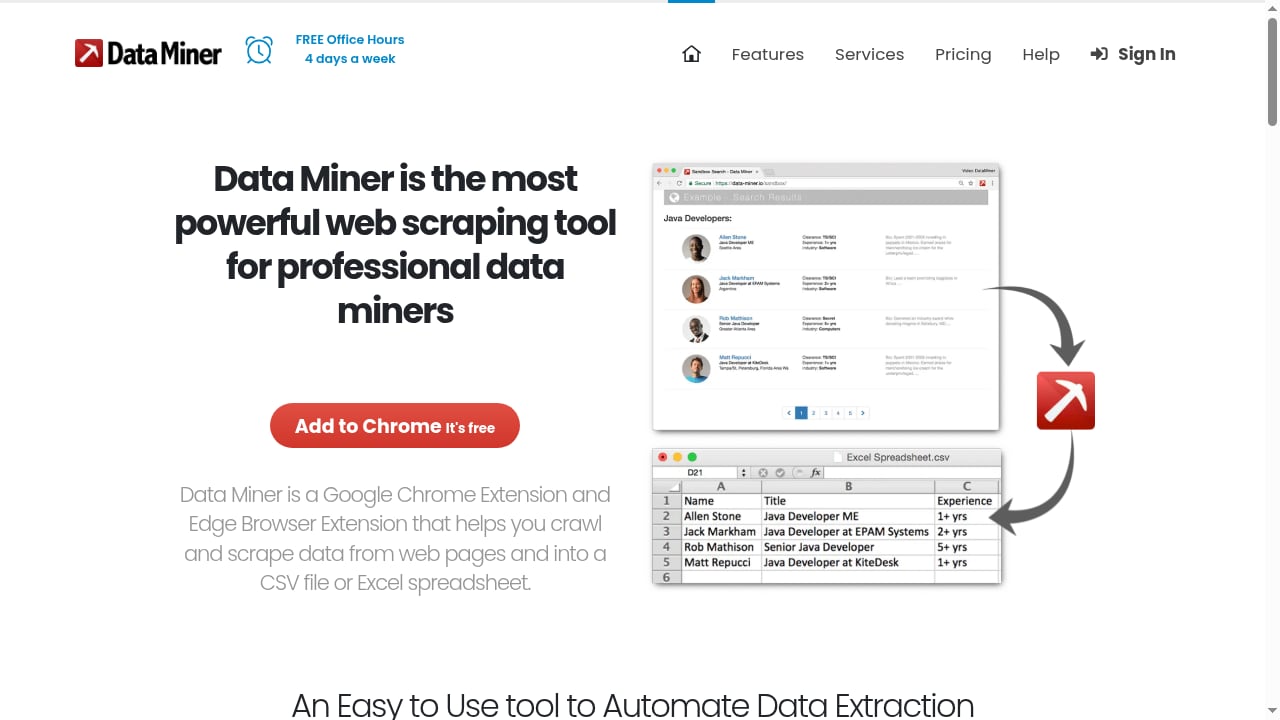
First viewport screenshot of dataminer.io.
dataminer.io首屏截图。
1. Web Scraper — 最适合可配置、可复用抓取的整体选择
Web Scraper将抓取视为可复用资产。你构建一个选择器站点地图,定义起始URL、导航层级、分页、滚动、点击和提取规则,然后稍后重新运行或移至云执行而无需重建。AI站点地图向导可以生成起始配置,高级站点地图构建器在检测不够时提供直接选择器控制。
其网站状态设置可以在提取前有条件地登录、选择位置或更改货币,这对于隐藏会话状态后数据的网站很重要。本地抓取免费且无限制,导出为CSV或XLSX,扩展适用于Chrome、Firefox和Edge。云计划起价约50美元/月,用于计划运行。
最适合: 可重复的多级项目,其中列表页及其详情页必须保持链接。注意: 学习曲线比一键工具更陡峭。
2. Data Miner — 最适合特定网站任务的配方库
Data Miner是一款Chrome和Edge扩展,使用配方抓取页面:基于HTML结构构建的网站特定指令集。它附带大型公共配方库,因此许多流行网站无需配置即可使用,配方创建器让你用点击式编辑器构建私有配方。即时表格抓取处理快速表格,下一页自动化处理分页,爬取跟随从列表页到详情页的链接。表单填写、自定义JavaScript、图像下载和Google Sheets连接完善了功能集。
数据在本地处理,供应商强调这是隐私优势。免费计划允许每月500页;Solo为19.99美元/月,Small Business为49美元/月。Chrome Web Store评分约为3.5/5,因此除了强大的配方覆盖外,界面可能显得过时。
最适合: 招聘、房地产、电子商务和销售团队,他们想要现成配方而非选择器树。注意: 免费页面上限低和界面打磨不足。
3. Instant Data Scraper — 最佳免费一键提取
Instant Data Scraper是该类别中最简单的入口点。在具有重复结构的页面上点击图标,它会高亮检测到的表格或列表;你修正列并导出。它自动处理分页和无限滚动,无需账户。
它完全免费且无使用上限,这解释了其规模:超过1,000,000用户和Chrome Web Store 4.9/5评分。代价是没有保存的站点地图式配置,因此每次都必须重新检测相同任务,复杂的自定义布局可能击败启发式方法。
最适合: 从表格或列表快速、免费的一次性导出。注意: 无复用性和无云运行。
4. Simplescraper — 从浏览器配方到API的最佳路径
Simplescraper让你在浏览器中点击配方,然后在云中运行或作为API端点调用。本地单页抓取无限且免费;多页和云运行使用积分。输出包括Google Sheets、JSON、webhooks和API响应,更高层级增加代理轮换。
这使其成为扩展类别中开发者想要按需数据而无需维护自己浏览器集群的最清晰桥梁。Plus计划起价约39美元/月,云积分在大任务上可能累积。
最适合: 将网站转变为计划数据馈送的开发者。注意: 大量使用时积分消耗。
5. Easy Scraper — 最适合一键分页
Easy Scraper读取当前页面,检测结构化数据,并跟随分页和无限滚动自动加载更多行。设置最少,导出为CSV和Excel,免费层涵盖休闲使用。付费计划起价约9美元/月,Pro层约29美元/月。
其Chrome Web Store评分在约1,300个评分中接近完美,为5.0/5,尽管用户群小于领先者。高级功能和模板覆盖比旧工具更薄。
最适合: 几乎无需配置的快速分页列表。注意: 生态系统较小。
6. Thunderbit — 最佳AI辅助提取和丰富
Thunderbit使用AI建议字段并可以丰富提取的行,这在不熟悉的布局上缩短了设置时间。它处理子页面、分页和无限滚动,并提供本地和云辅助执行。免费额度很小,因此适合在付费承诺前进行评估和轻量任务。
最适合: 希望AI映射字段而非手动构建选择器的用户。注意: 免费层有限,且控制确定性不如选择器构建器。
7. Listly — 最适合跨打开的标签页提取
Listly专注于跨多个打开的标签页收集数据,分页和自动滚动因计划而异。它在本地运行,有云选项,免费额度有限。对于涉及并排比较许多页面的研究工作流,基于标签页的模型与单页抓取器确实不同。
最适合: 多标签页研究和比较任务。注意: 功能受计划限制。
8. Table Capture — 最适合网页表格和电子表格导出
Table Capture是将现有HTML表格移入电子表格的最专注选项。核心免费但有 限制,付费支持增加滚动和多页表格处理。它在本地运行,可选云功能。
如果你的任务字面上是“将此表格完整格式地放入Excel”,专用表格工具通常胜过通用抓取器。它不是列表到详情页抓取的合适选择。
最适合: 干净的表格到电子表格传输。注意: 表格之外的范围狭窄。
9. Bardeen — 当抓取为自动化提供数据时最佳
Bardeen将提取与工作流自动化配对:抓取的行可以通过剧本流入Google Sheets、Notion、Slack和其他应用。它使用积分模型,有小免费层和约10美元/月起的付费计划。它倾向于销售和上市团队,积分在大任务上消耗很快。
最适合: 与下游操作相关的抓取。注意: 积分成本和销售导向。
10. Browse AI — 最适合计划监控
Browse AI在浏览器中记录任务,然后按计划在云中运行,输出表格和webhook。它有免费平台计划和约19美元/月起的付费层。由于执行基于云,它不太像经典的“扩展抓取器”,而更像从浏览器配置的监控层。
最适合: 随时间监控页面变化。注意: 选择器控制不如站点地图工具精细。
比较表:哪个扩展适合哪项任务
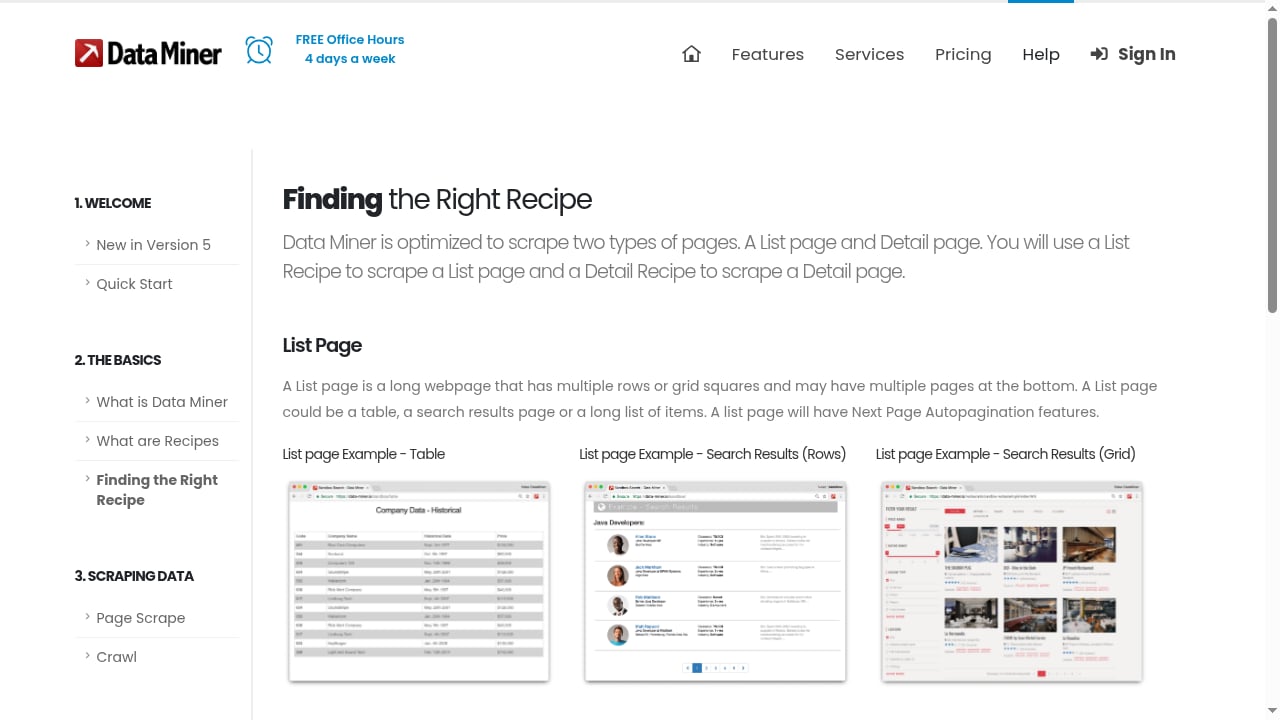
First viewport screenshot of dataminer.io.
| 扩展 | 最适合 | 免费入口 | 多页 | 执行 |
|---|---|---|---|---|
| Web Scraper | 可复用多级抓取 | 无限本地 | 分页、滚动、点击、详情页 | 本地+云 |
| Data Miner | 预建配方 | 500页/月 | 分页和爬取 | 主要本地 |
| Instant Data Scraper | 免费一次性表格 | 无限 | 分页和无限滚动 | 本地 |
| Simplescraper | 抓取到API工作流 | 无限单页 | 深度抓取、批量URL | 本地+云+API |
| Easy Scraper | 一键分页 | 是 | 分页和滚动 | 本地+云 |
| Thunderbit | AI辅助提取 | 小额度 | 子页面、分页、滚动 | 本地+云辅助 |
| Listly | 多标签页提取 | 有限 | 因计划而异 | 本地+云 |
| Table Capture | 网页表格 | 免费核心有限制 | 付费支持 | 本地+云 |
| Bardeen | 自动化工作流 | 100积分/月 | 依赖剧本 | 云辅助 |
| Browse AI | 计划监控 | 免费平台计划 | 远程深度抓取 | 云 |
定价和计划限制会变化;购买前确认当前额度。
当浏览器扩展是错误工具时
First viewport screenshot of www.adscrawl.net.
扩展在你的浏览器内运行,这正是它们对小任务愉快而大规模痛苦的原因。三个信号告诉你该继续前进:
- 网站阻止你。 扩展没有内置代理轮换或反机器人处理。如果页面返回CAPTCHA或空壳,你需要基础设施。
- 数据在登录或重JavaScript后面。 有状态的远程浏览器会话比本地标签页更可靠地处理认证的动态页面。
- 你需要无人值守的量。 计划运行、并发和结构化JSON输出属于API,而非扩展。
这就是互补工具进入画面的地方。AdsCrawl提供同步端点用于渲染HTML、Markdown、截图和SPA提取,以及有状态的Chromium会话,可连接到Playwright、Puppeteer或原始CDP客户端,具有托管浏览器身份和代理路由。它不是扩展,也不在此排名,但当在浏览器中工作的配方开始大规模失败时,它是合理的下一步。有关浏览器基础设施选项的更深入比较,请参阅我们的云浏览器基础设施排名和会话持久化指南,以在运行之间保持登录活跃。
实用工作流:从扩展到管道
First viewport screenshot of dataminer.io.
2026年的现实工作流通常结合两层:
- 在浏览器中原型。 使用Data Miner或Web Scraper确认页面结构,识别所需字段,并验证数据值得收集。
- 稳定配方。 保存配置,针对几个分页页面测试,并注意它在哪里中断(登录、懒加载、地理变体)。
- 将困难目标移至API。 将认证或JavaScript繁重的页面发送到浏览器自动化API,并保留扩展用于快速临时检查。
- 连接输出。 在电子表格或仓库中合并浏览器导出与API JSON,并计划API侧。
对于将渲染页面与商务数据结合使用的团队,我们的将AdsCrawl与价格API配对指南介绍了丰富步骤。
相关阅读
- 如何将AdsCrawl与Cloudflare开发者文档一起使用 - 了解如何将AdsCrawl的浏览器自动化API与Cloudflare开发者文档配对,以抓取渲染的开发者文档并构建可靠的AI上下文管道。
- AdsCrawl vs ScreenshotEngine vs Screenshotlayer:2026指南 - 比较AdsCrawl、ScreenshotEngine和Screenshotlayer在截图、浏览器控制和数据提取方面的表现。为你的工作流找到合适的工具。
- AdsCrawl vs Lexmount:面向AI代理的云浏览器API - 比较AdsCrawl和Lexmount Cloud Browser API for AI agents。了解哪个提供更好的CDP控制、数据提取、定价和代理支持。
来源与进一步阅读
- 2026年8个最佳网页抓取浏览器扩展 | Web Scraper - 八个网页抓取浏览器扩展的实用比较,涵盖一次性提取、可复用抓取器配置、多页导航、云执行、扩展和阻止
- 6个最佳网页抓取浏览器扩展 - 按定价、功能和Chrome Web Store评分比较2026年6个最佳网页抓取浏览器扩展,从Instant Data Scraper到Easy Scraper。
- 2026年15个最佳网页抓取工具(以及我会为每项工作使用哪个) - Firecrawl、Bright Data、Apify、Octoparse、Crawl4AI和另外10个网页抓取工具在价格、反机器人处理以及它们为AI代理提供数据的能力方面的比较。
常见问题
2026年最佳网页抓取浏览器扩展是什么?
没有单一赢家,但Web Scraper在可复用、多级抓取方面工作流覆盖最广,而Instant Data Scraper是一次性表格的最佳免费选择。当公共配方已匹配你的目标网站时,Data Miner最强。
网页抓取浏览器扩展免费吗?
许多是免费的。Instant Data Scraper完全免费且无上限,Web Scraper提供无限本地抓取,Simplescraper允许无限单页本地运行。当你需要云执行、调度、更高页面限制或API输出时,会出现付费层。
浏览器扩展可以抓取多个页面吗?
可以。此列表上的大多数工具处理分页和无限滚动,并且有几个支持列表到详情页抓取。Web Scraper和Data Miner对多级工作流最明确,而Simplescraper和Browse AI将多页运行推入云中。
何时应从扩展切换到抓取API?
当你遇到阻止、CAPTCHA、认证会话、JavaScript渲染内容或无人值守量时切换。扩展没有代理基础设施,因此浏览器自动化API是这些情况的自然升级。
使用浏览器扩展抓取合法吗?
合法性取决于网站条款、数据类型和你的司法管辖区。扩展使收集变得容易,但你仍有责任遵守服务条款、robots指令、个人数据规则和速率限制。
结论
2026年扩展市场清晰地分为三项工作:快速一次性提取(Instant Data Scraper、Easy Scraper、Table Capture)、可复用配置抓取(Web Scraper、Data Miner、Simplescraper)以及浏览器配置的自动化或监控(Bardeen、Browse AI、Listly、Thunderbit)。按工作选择,而非按星级评分。
从匹配你第一个任务的工具的免费层开始,在真实页面上验证,只有在你需要云运行或更高限制时才付费。当浏览器不再足够时,将困难页面交给AdsCrawl等基础设施,并保留扩展用于它最擅长的事情:快速、本地、可见页面的提取。