
如何将 AdsCrawl 与 SerpApi 结合使用:广告 + 页面工作流
了解如何将 AdsCrawl 浏览器自动化与 SerpApi 搜索数据相结合,以捕获广告 SERP、验证落地页并构建可靠的广告情报。
如何将 AdsCrawl 与 SerpApi 结合使用
搜索广告会给你两种截然不同的数据:广告本身(标题、文案、目标 URL、位置)以及广告指向的页面(渲染、布局、优惠、跟踪)。SerpApi 非常擅长前半部分。AdsCrawl 则为后半部分而生。两者结合使用,可以闭环连接广告主在 SERP 中承诺的内容与用户点击后实际看到的内容。
本文解释了分工,演示了一个具体设置,并展示了一个可运行的工作流,你可以将其用于竞争性广告研究、品牌监控或联盟合规检查。
为什么要结合 AdsCrawl 和 SerpApi
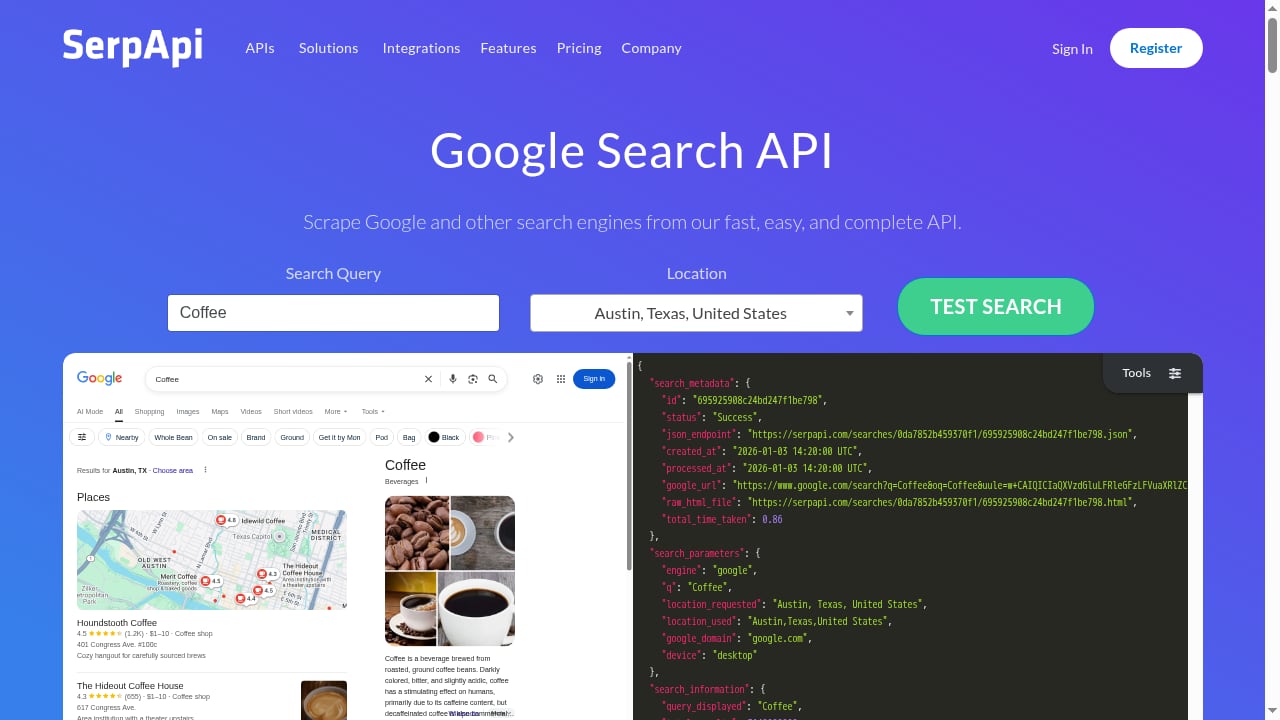
First viewport screenshot of SerpApi: Google Search API.
SerpApi: Google Search API 的首屏截图。
SerpApi 为 Google Search、Google Ads、Google Maps、Google News 以及许多其他引擎返回结构化 JSON。它处理代理、验证码和解析,因此你无需维护抓取器就能获得干净的广告块。
SerpApi 不做的是渲染目标页面。它告诉你广告存在以及指向哪里。它无法向你展示落地页是否加载 cookie 横幅、是否按地理位置替换创意,或者是否向移动用户提供不同的优惠。
AdsCrawl 填补了这一空白。它通过统一的 API 提供真实浏览器会话,因此你可以捕获截图、提取 HTML 或 Markdown,并驱动远程 Chrome DevTools Protocol (CDP) 会话。这使得大规模验证点击后体验成为可能,而不是仅凭 URL 猜测。
| 任务 | SerpApi | AdsCrawl |
|---|---|---|
| 检索 Google Ads 块 | 是,结构化 JSON | 否 |
| 处理搜索验证码和代理 | 是 | 不是其重点 |
| 渲染 JavaScript 密集型页面 | 否 | 是 |
| 捕获截图 | 否 | 是 |
| 提取 HTML 或 Markdown | 否 | 是 |
| 控制实时浏览器会话 | 否 | 是,通过 CDP |
如果你的目标只是广告文案和关键词覆盖,仅 SerpApi 就足够了。当你需要确认点击后发生了什么时,这种组合就成了实际选择。
先决条件和设置
First viewport screenshot of SerpApi Release Notes - SerpApi.
SerpApi Release Notes - SerpApi 的首屏截图。
你需要两个凭证:一个 SerpApi API 密钥和一个 AdsCrawl API 密钥。两者都可以在免费或入门级计划中获得,这足以在扩展之前对工作流进行原型设计。
第 1 步:获取你的 API 密钥
创建一个 SerpApi 账户,并从你的仪表板复制密钥。然后创建一个 AdsCrawl 账户,从密钥管理仪表板生成一个密钥,并记下你的使用限制。AdsCrawl 使用基于积分的计费,因此请尽早跟踪消耗。
将两个密钥存储在环境变量中,而不是源代码中:
export SERPAPI_API_KEY="your_serpapi_key"
export ADSCRAWL_API_KEY="your_adscrawl_key"
第 2 步:使用 SerpApi 拉取广告结果
针对商业关键词的基本 Google Search 请求会返回自然结果,并在存在广告时返回一个 ads 块。在 Python 中,调用如下所示:
import os
import requests

params = {
    "engine": "google",
    "q": "best crm for small business",
    "location": "United States",
    "google_domain": "google.com",
    "gl": "us",
    "hl": "en",
    "api_key": os.environ["SERPAPI_API_KEY"],
}

response = requests.get("https://serpapi.com/search", params=params)
data = response.json()

for ad in data.get("ads", []):
    print(ad.get("title"), ad.get("link"))
响应是 JSON,因此你可以按位置过滤、提取显示链接并收集目标 URL,而无需自己解析 HTML。如果你想更深入地了解搜索数据 API 在这类数据丰富方面的比较,请参阅我们对电商市场数据 API 产品的分析。
第 3 步:使用 AdsCrawl 渲染每个目标页面
一旦你有了广告落地页列表,将每个 URL 传递给 AdsCrawl。一个用于捕获截图的最小 cURL 调用如下所示:
curl -X POST "https://api.adscrawl.com/v1/screenshot" \
  -H "Authorization: Bearer $ADSCRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://example.com/landing-page",
    "full_page": true,
    "wait_until": "networkidle"
  }'
对于需要渲染后的 DOM 而不是图像的页面,请改为请求 HTML 或 Markdown。当你想要对比标题文本、检测注入脚本或将干净内容输入分析模型时,这很有用。
第 4 步:连接两个数据集
连接键是目标 URL。首先对其进行规范化——去除跟踪参数、将主机名小写并解析重定向——然后将 SerpApi 广告记录与 AdsCrawl 捕获结果匹配。结果是一行对应一个广告,同时包含 SERP 上下文和渲染后的页面状态。
一个实用的流水线示例
First viewport screenshot of SerpApi Release Notes - SerpApi.
SerpApi Release Notes - SerpApi 的首屏截图。
一个现实的广告情报任务有四个阶段:
- 关键词批次。 读取包含关键词和位置的 CSV。
- SERP 收集。 为每一对查询 SerpApi,并存储原始 JSON 以供审计。
- 页面捕获。 将每个广告目标发送到 AdsCrawl 以获取截图和 HTML 快照。
- 分析。 将广告文案与落地页标题进行比较,标记不匹配项,并导出报告。
import os, requests

ADSCRAWL_KEY = os.environ["ADSCRAWL_API_KEY"]

def capture(url):
    r = requests.post(
        "https://api.adscrawl.com/v1/screenshot",
        headers={"Authorization": f"Bearer {ADSCRAWL_KEY}"},
        json={"url": url, "full_page": True, "wait_until": "networkidle"},
        timeout=60,
    )
    r.raise_for_status()
    return r.json()

for ad in ads_from_serpapi:
    shot = capture(ad["link"])
    ad["screenshot_id"] = shot["id"]
尽可能并发运行捕获。AdsCrawl 支持并行浏览器执行,当一组关键词每次运行产生数十个广告时,这一点很重要。
这种组合解决的问题
First viewport screenshot of Amazon Product Protection Plan API - SerpApi.
Amazon Product Protection Plan API - SerpApi 的首屏截图。
广告与页面不匹配。 你可以证明广告中的标题是否出现在落地页上,这对于合规审查和联盟监控很有用。
地理和设备差异。 页面可能因地区或用户代理而呈现不同。SerpApi 允许你定位位置和设备;AdsCrawl 允许你使用定义的指纹配置文件重现渲染。
损坏或重定向的目标。 SerpApi 给你声明的链接。AdsCrawl 向你展示浏览器在重定向后实际落地的位置,以及页面是否渲染。
渲染失败。 有些页面返回 200 状态码,但在没有 JavaScript 执行的情况下正文为空。真实浏览器会话会立即暴露这一点,而普通的 HTTP 获取永远不会。
审计追踪。 将原始 SerpApi JSON 与 AdsCrawl 截图一起存储,可以创建证据,当广告活动发生变化或客户对发现提出异议时,你可以重新查看。
选择正确的工作分工
当问题关于搜索结果时使用 SerpApi:出现了哪些广告、以什么顺序、什么文案、针对哪个查询和位置。当问题关于页面时使用 AdsCrawl:渲染了什么、加载了什么、用户看到了什么。
如果你已经运行了一个抓取栈,并且正在浏览器 API 和基于获取的工具之间做决定,我们关于 AdsCrawl 与 Zenrows 的比较涵盖了真实 CDP 会话在哪些方面优于反机器人获取层。对于还从其他提供商拉取排名和关键词数据的团队,同样的模式适用——请参阅我们 AdsCrawl 与 DataForSEO 工作流 中类似分工如何运作。
相关阅读
- AdsCrawl vs Thunderbit vs BrowserCloud: 2026 年比较 - 在浏览器控制、提取、反机器人处理和定价方面比较 AdsCrawl、Thunderbit 和 BrowserCloud,为你的工作流选择正确的工具。
- AdsCrawl vs ScreenshotAPI:哪个浏览器 API 更合适? - 比较 AdsCrawl 和 ScreenshotAPI 在截图、HTML 提取和浏览器自动化方面的表现。了解每个 API 的优势以及哪个适合你的工作流。
- Oxylabs 代理与网页抓取平台 2026 年评测 - 基于证据的 Oxylabs 评测:代理类型、Web Scraper API、Web Unblocker、定价信号、设置、限制以及谁应该选择它。
来源与进一步阅读
- Web Scraping: A Better Way Around It Using SerpApi - Medium - 数据质量:SerpApi 以 JSON 格式提供结构化且干净的数据,而传统网页抓取通常产生混乱且不一致的结果。SerpApi 的一些实际用例 1。
- How I Built a Google Ads Scraper in Python Using SerpApi #Python #WebScraping #SerpApi - 在这个视频中,我将带你了解我如何使用 Python 和 SerpApi 构建一个 Google Ads 抓取器——一个强大的工具,让你合法地提取 Google Search ...
- Build a Google Ads Scraper with Python & SerpApi 🚀 #Python #GoogleAds #SerpApi - 使用 Python 和 SerpApi 构建一个可扩展的 Google Ads 抓取器,以高效收集结构化的 Google Search Ads 数据。这个项目演示了如何集成...
常见问题
如果 SerpApi 已经返回广告数据,我还需要 AdsCrawl 吗? 只有当你关心目标页面时才需要。SerpApi 覆盖 SERP;AdsCrawl 覆盖点击后发生的事情。
我可以不使用 SerpApi 而使用 AdsCrawl 吗? 可以。AdsCrawl 可独立用于截图、HTML 提取和浏览器自动化。SerpApi 只是提供广告 URL 来喂给它。
这种方法适合大型关键词集吗? 适合,但需要规划。在你的计划限制内批量发送 SerpApi 请求,并并发运行 AdsCrawl 捕获。缓存结果,以免重新渲染未更改的页面。
如何处理同意墙后面的页面? 首先捕获初始状态,然后使用 AdsCrawl CDP 会话与页面交互——接受或关闭同意——并再次捕获。这样你可以同时获得首次访问和同意后的视图。
我应该以什么格式存储结果? 保留原始 SerpApi JSON 以确保可审计性,将 AdsCrawl 截图存储为图像引用,并维护一个以规范化目标 URL 为键的连接表。
结论
SerpApi 回答搜索引擎展示了什么。AdsCrawl 回答浏览器渲染了什么。两者结合,将广告研究从链接列表转变为从 SERP 展示到落地页状态的完整用户旅程的经过验证的记录。从一个关键词开始,确认连接逻辑有效,然后在捕获和存储步骤稳定后扩展批次。